deepseek api
DeepSeek - 探索未至之境 · 极致成本、零门槛迁移的大模型推理 API
无需配置代码,直接与 DeepSeek-R1 深度思考对话。
上下文缓存直降 90% 开销,提供坚实 SLA 保证。
极简架构创新赋能工业级推理,让大模型应用触手可及
DeepSeek API 致力于抹平技术鸿沟与昂贵算力门槛。通过 DualPipe 双向流水并行与多 Token 预测技术,集群吞吐利用率达到极致。
同时提供独创的上下文缓存(Context Caching)功能,自动缓存历史 Prompt,输入 Token 成本降至传统商业 API 的十分之一。
API TOKEN PRICING // 亲民透明的计费标准
每 100 万 Token(1M Tokens)调用单价| 模型型号 / 接入项目 | DeepSeek 官方 API | 国际主流推理大模型 A | 国内头部模型厂商 B | 第三方聚合中转平台 C |
|---|---|---|---|---|
| DeepSeek-V3 输入价格 (未命中缓存) | ¥ 1.00 / 1M | ¥ 18.00 / 1M | ¥ 12.00 / 1M | ¥ 4.00 / 1M |
| DeepSeek-V3 输入价格 (命中缓存 90% OFF) | ¥ 0.10 / 1M | ¥ 4.50 / 1M | ¥ 3.00 / 1M | 无优惠 |
| DeepSeek-V3 输出价格 | ¥ 2.00 / 1M | ¥ 72.00 / 1M | ¥ 36.00 / 1M | ¥ 10.00 / 1M |
| DeepSeek-R1 深度思考推理输出 | ¥ 16.00 / 1M | ¥ 430.00 / 1M | ¥ 160.00 / 1M | ¥ 60.00 / 1M |
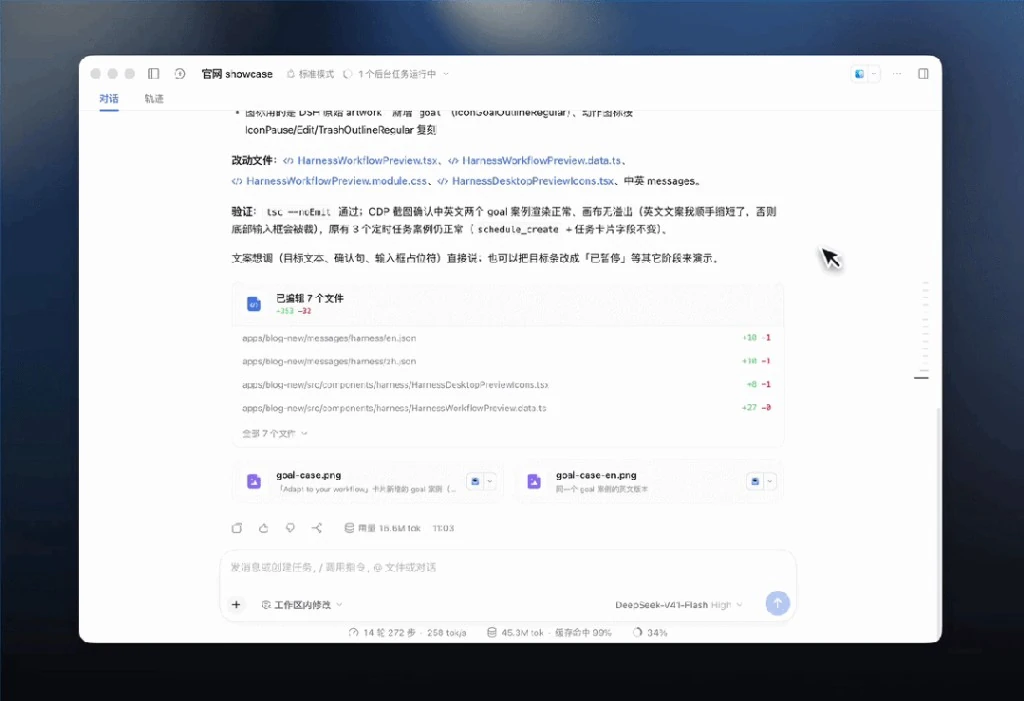
01. DeepSeek Harness 开源评估
提供官方开源的大模型评测标准框架,支持学术界一键复现 AIME、MATH-500 等多项核心基准。
02. 蒸馏小模型与私有化
提供 1.5B/7B/14B/32B/70B 蒸馏版开源模型权重,支持在单张消费级显卡或私有集群本地部署。
& FUNCTION CALL
03. 严谨结构化输出
原生支持 Function Calling 工具调用与严格 JSON Schema 约束,轻松编排企业多智能体工作流。
开发者常见问答与集成指南
如何通过 OpenAI SDK 快速调用 DeepSeek API?
DeepSeek API 完全兼容 OpenAI 官方 SDK。开发者仅需在初始化客户端时,将 base_url 指定为 https://api.deepseek.com/v1,并填入从开放平台申请的 api_key,即可直接调用 deepseek-chat 或 deepseek-reasoner 模型。
DeepSeek Harness 包含哪些评测基准?
DeepSeek Harness 是深度求索官方开源的端到端大模型基准评测套件。全面涵盖 AIME 2024、MATH-500、MMLU-Pro、Codeforces 及 SWE-bench 等高难度基准,支持全球学术界对模型能力进行透明、客观的复现测试。
什么是上下文缓存(Context Caching)及其实际降本幅度?
上下文缓存技术能够自动识别请求前缀中的重复内容。一旦命中系统缓存,输入 Token 的计费价格将享受最高 90% 的折扣,降至每百万 Token 0.1 元,尤其适用于知识库检索、多轮对话与超长文档分析任务。